📌 이 글은 삽질의 기록입니다. 맥미니에 로컬 LLM(gemma)을 올려서 Claude 사용량을 아껴 보려다가, "아낀 줄 알았는데 안 아껴지고 있었다"는 걸 발견하고, 결국 Haiku와 정확도 대결까지 시킨 과정을 정리했어요. 결론만 궁금하시면 맨 아래 최종 요약으로 바로 가셔도 됩니다.
Claude Code를 매일 쓰다 보면 꼭 만나는 화면이 있습니다. 사용량 한도요.
긴 로그를 읽히고, 문서를 요약시키고, 메일 정리를 시키다 보면 생각보다 금방 바닥이 나더라고요. 그런데 가만 보니 그중 상당수는 "긴 글을 읽고 몇 줄로 줄이는 일"이었습니다. 굳이 똑똑한 클라우드 모델이 할 일인가 싶었어요.
그래서 맥미니 안에서 돌아가는 로컬 LLM에게 이런 일을 넘겨 보기로 했습니다.
로컬 LLM이 뭔가요?
💡 로컬 LLM: 인터넷 너머 회사 서버가 아니라 내 컴퓨터 안에서 돌아가는 AI 모델입니다. 아무리 써도 요금이나 사용량 한도가 없고, 자료가 밖으로 나가지 않아요. 대신 내 컴퓨터 성능만큼만 똑똑하고 빠릅니다.
제가 쓴 조합은 이렇습니다.
- Ollama: 로컬 모델을 내려받고 돌려 주는 프로그램. 맥용 앱이 있어요.
- gemma4:12b: 구글이 공개한 gemma 모델 중 120억 파라미터짜리. 왜 이걸 골랐는지는 바로 아래에서 설명할게요.
- Claude Code: 평소 쓰는 메인 AI. 여기서 gemma에게 일을 넘기는 구조를 만듭니다.
목표는 간단했어요. "긴 글 읽기는 gemma가, 판단은 Claude가."
1단계: 내 맥미니에 맞는 모델 고르기
로컬 LLM에서 제일 먼저 부딪히는 건 "내 컴퓨터에서 어떤 크기까지 돌아가나?"예요. 모델은 클수록 똑똑하지만, 돌리는 동안 그 크기만큼 메모리를 통째로 차지합니다.
💡 맥은 메모리가 곧 그래픽 메모리: 애플 실리콘 맥은 CPU와 GPU가 메모리 하나를 같이 씁니다(통합 메모리). 그래서 로컬 LLM을 돌릴 때는 "메모리가 몇 GB냐"가 사실상 전부예요.
제 맥미니 상황은 이랬습니다.
| 항목 | 제 맥미니 |
|---|---|
| 칩 / 저장공간 | M6 / 512GB SSD |
| 메모리 | 24GB |
| 평소 남는 메모리 | 약 27% (6~7GB 정도) |
| gemma4:12b 모델 파일 크기 | 약 8GB |
후보는 Ollama가 추천해 주는 로컬 모델 3개였어요. Ollama는 모델마다 필요한 메모리(VRAM)를 같이 알려 줍니다.
| 모델 | 크기 | Ollama 안내 필요 메모리 | 24GB 맥미니에서 |
|---|---|---|---|
| qwen3.5:4b | 40억 | 6GB | 넉넉하게 들어가지만 너무 작아서 제외 |
| gemma4:12b | 120억 | 11GB | 여유 있게 들어감 → 최종 선택 |
| qwen3.8:27b | 270억 | 28GB | 메모리 전체보다 큼 |
4b는 메모리 걱정은 없지만, 긴 문서를 읽고 정확히 뽑아내기엔 너무 작다고 보고 일찌감치 뺐어요. 그럼 남은 건 12b와 27b. 욕심이 났습니다.
삽질: qwen을 올렸더니 맥미니가 기어가기 시작했다
처음엔 qwen3.8:27b를 올려 봤어요. 270억 파라미터짜리라 더 똑똑할 것 같았거든요. 그런데 Ollama가 안내하는 필요 메모리가 28GB. 제 맥미니는 24GB입니다. 메모리 전체보다 큰 모델을 올린 거죠. 당연히 메모리가 모자라서 스왑이 걸렸고, 답 한 줄 나오는 데 한참이 걸릴 만큼 엄청 느려졌어요.
💡 스왑(swap): 메모리(DRAM)가 모자라면 맥이 당장 안 쓰는 내용을 SSD로 잠깐 옮겨 두고 자리를 만듭니다. SSD는 메모리보다 훨씬 느려서, 모델처럼 메모리를 통째로 계속 읽어야 하는 프로그램은 스왑이 걸리는 순간 속도가 바닥으로 떨어져요.

여기서 배운 게 하나 있어요. 로컬 LLM은 "돌아가느냐"가 아니라 "메모리 안에 쏙 들어가느냐"가 기준이라는 거예요. 메모리를 넘기면 돌아가긴 해도 못 쓸 만큼 느려집니다. 그래서 메모리 안에 여유 있게 들어가는 gemma4:12b로 정했습니다.
사실 gemma도 넉넉하진 않아요. 평소 남는 6~7GB에 8GB짜리 모델을 올리면 다른 앱들이 자리를 내줘야 해요. 정리한 기준은 이렇습니다.
- 한국어가 되면서 24GB 안에 스왑 없이 들어가는 모델 → gemma4:12b를 기본으로.
- 한국어는 약하지만 빠르고 코드에 강한 모델 → gpt-oss:20b를 영어·코드용 예비로.
- 쓸 때만 올리고 바로 내리기 → 아래에서 나올
keep_alive 1m설정이 이 이유예요. 1분 동안 안 쓰면 메모리에서 내려서 다른 앱 자리를 비워 줍니다.
⚠️ 모델이 차지하는 메모리는 읽는 글 길이(컨텍스트)를 늘리면 더 커집니다. 처음에 한 번에 읽는 길이를 8,192토큰으로 작게 시작한 것도 같은 이유예요.
2단계: 맥미니에 Ollama와 gemma 올리기
Ollama를 설치하고 나면 터미널에서 모델을 내려받아 바로 말을 걸어 볼 수 있습니다.
여기까지는 정말 쉽습니다. 문제는 Claude Code가 이 gemma에게 일을 시키게 만드는 것이었어요.
3단계: Claude Code에서 gemma를 부르게 만들기
Claude Code는 MCP라는 방식으로 외부 도구를 붙일 수 있습니다. 그래서 "질문을 받으면 Ollama에 넘기고 답을 돌려주는" 작은 파이썬 스크립트(ollama-mcp.py)를 만들어 도구로 등록했어요. Claude 입장에서는 ask_local_llm이라는 도구가 하나 생긴 셈입니다.
스크립트에 넣어 둔 설정은 이렇습니다.
| 설정 | 값 | 쉽게 말하면 |
|---|---|---|
| 모델 | gemma4:12b |
기본으로 부를 로컬 모델 |
| num_ctx | 8192 | 한 번에 읽을 수 있는 길이(토큰). 나중에 긴 파일을 넘기면서 32,768까지 늘림 |
| think | false | 속으로 길게 생각하는 모드 끄기. 요약·추출엔 필요 없음 |
| keep_alive | 1m | 1분 동안 안 쓰면 메모리에서 내리기 |
| timeout | 600초 | 10분 넘게 답이 없으면 실패 처리 |
그리고 일을 넘겨받을 서브에이전트 local-worker를 만들었습니다. "긴 자료를 받으면 이 도구로 gemma에게 넘겨라"라는 역할이에요. (서브에이전트가 뭔지는 지난 글에 정리해 두었습니다.)
📌 참고로 Claude 한도가 바닥났을 때 대신 쓰는 Codex에도 같은 스크립트를 ollama_local이라는 이름으로 등록해 뒀어요. 한 번 만들어 두니 양쪽에서 같은 gemma를 같이 씁니다.
4단계: 토큰이 하나도 안 줄고 있었다
잘 돌아가는 것 같았습니다. 도구 설명에도 떡하니 "no Claude tokens"라고 써 놨고요.
그런데 Codex(GPT 모델)에게 제 에이전트 구성을 검토시켰더니 이런 지적이 돌아왔어요.
🔍 검토 결과 요약: "local-worker는 입력을 읽어 MCP로 보내고 답변을 전달합니다. 따라서 도구 설명의 'no Claude tokens'를 전체 경로의 Claude 사용량이 없다는 뜻으로 해석하면 안 됩니다. Haiku 호출이 존재합니다."
무슨 말이냐면, local-worker 자체가 Claude Haiku로 돌아가고 있었던 거예요. Haiku가 긴 파일을 처음부터 끝까지 다 읽은 다음 그걸 gemma에게 넘기고 있었습니다. 읽는 순간 이미 Claude 토큰은 나간 거죠.
정리하면 이런 구조였습니다.
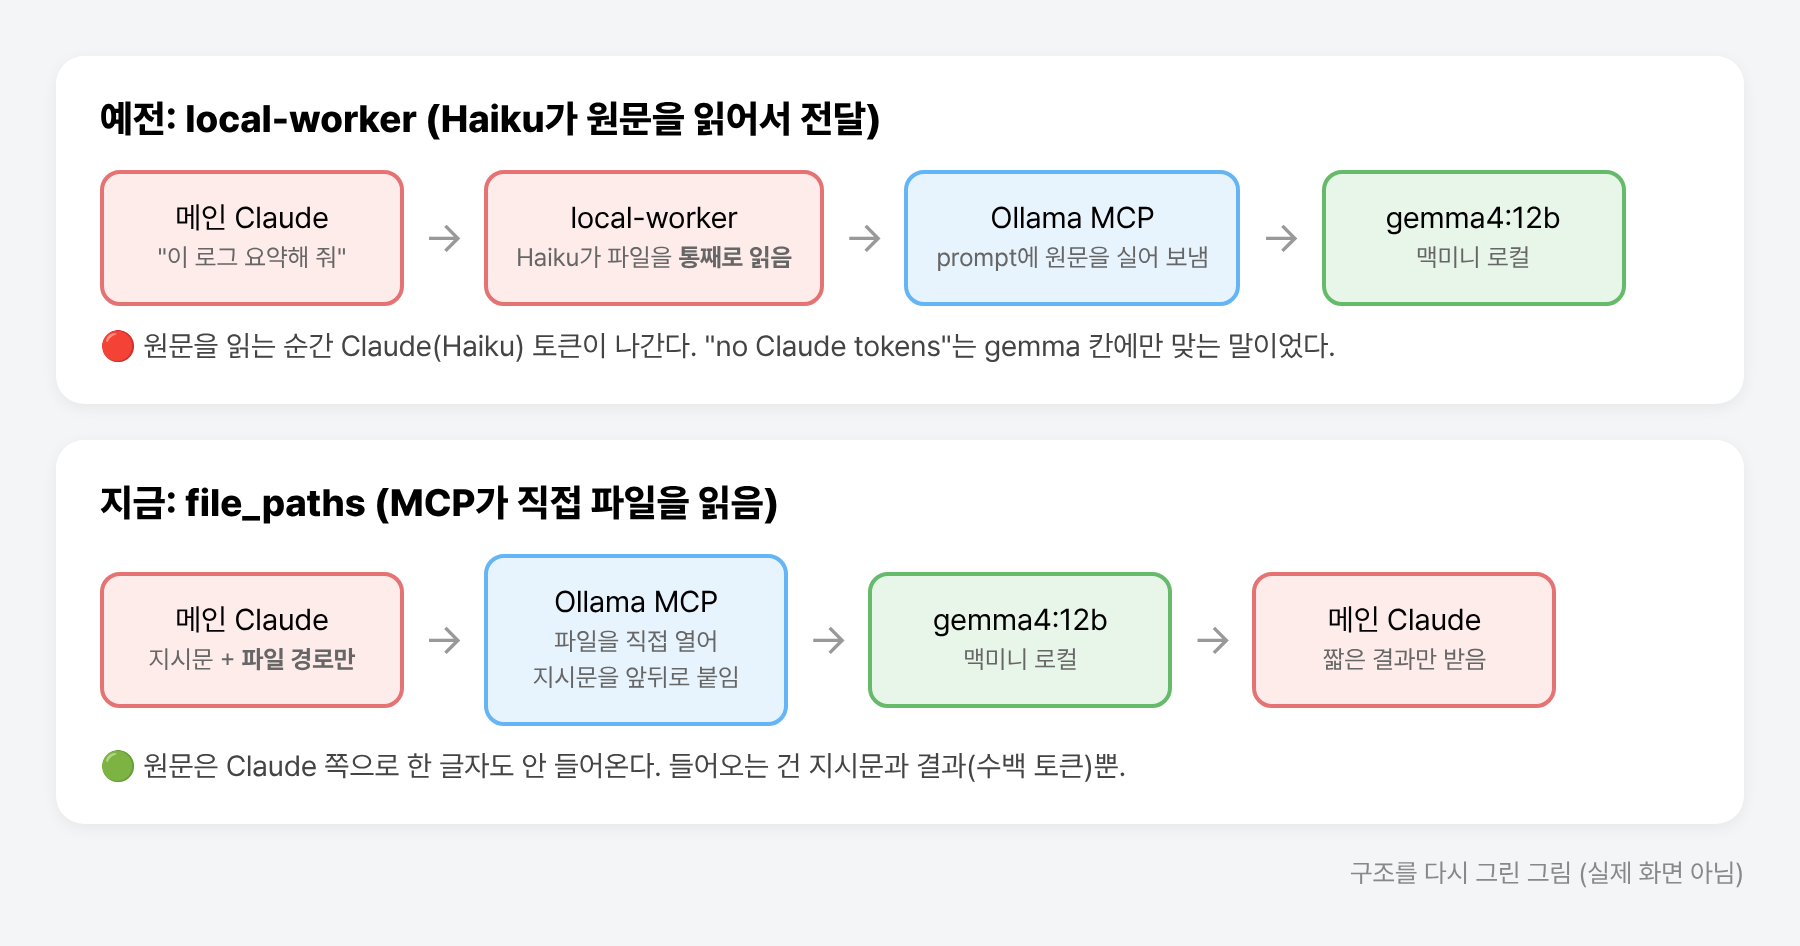
해결: 파일 경로만 넘기기 (file_paths)
고친 방법은 의외로 단순했어요. 도구에 file_paths라는 입력을 추가해서, Claude는 파일 경로만 넘기고 파일은 MCP 스크립트가 직접 열어 gemma에게 보내도록 바꿨습니다. 중간에 Haiku를 거칠 필요가 없으니 메인이 직접 도구를 부르면 끝이에요.
이러면 Claude 쪽에 들어오는 건 "이 파일에서 이것 좀 뽑아 줘"라는 지시문과 gemma가 돌려준 짧은 결과뿐입니다.
5단계: 그런데 gemma가 Haiku만큼 정확할까?
토큰은 아끼게 됐는데, 이번엔 다른 걱정이 생겼습니다. "싼 게 비지떡이면 어떡하지?" gemma가 틀린 답을 주면 Claude가 다시 원문을 읽어야 하고, 그럼 아낀 게 아니잖아요.
그래서 Claude에게 제대로 된 비교 실험을 맡겼습니다. 조건은 이랬어요.
- 작업 두 가지: ① 긴 테스트 로그에서 실패한 테스트 찾기 ② 문서(회의록, 청구서, 릴리스 노트 등)에서 날짜·금액·담당자 같은 항목 뽑기
- 문제 수: 작업마다 100개. 정답을 미리 심어 둔 가짜 로그·문서를 만들어서 채점이 자동으로 되게.
- 선수: gemma(로컬), Haiku 100개씩. Sonnet은 기준점으로 20개만.
- 같은 조건: 같은 지시문, 같은 입력. gemma는 실제로 쓰는 도구 경로 그대로.
- 통과선은 측정 전에 고정: gemma 점수 95% 이상, Haiku보다 3%p 넘게 뒤지지 않을 것.
💡 통과선을 결과 보기 전에 정해 둔 게 포인트예요. 결과를 보고 기준을 정하면 아무래도 마음이 약해지니까요.
삽질: 긴 글을 주면 gemma가 숙제를 까먹는다
실험을 진행하다가 이상한 걸 발견했습니다. 긴 자료를 주면 gemma가 맨 앞에 써 둔 지시문을 잊어버리는 거예요. 자료가 길수록 "뭘 하라고 했더라?" 상태가 되는 거죠.
해결은 자료 뒤에 지시문을 한 번 더 붙이는 것이었습니다. "자, 이제 위 자료로 이걸 해" 하고 마지막에 다시 말해 주는 거죠. 사람도 긴 회의 끝에는 할 일을 다시 정리해 주잖아요. 이건 도구 스크립트 자체를 고쳐서 평소 쓸 때도 똑같이 적용되게 했습니다.
본 실행: gemma는 한 시간, Haiku는 11분
본 실행은 gemma와 Claude를 동시에 돌렸어요. 결과가 나오는 속도부터 차이가 컸습니다.
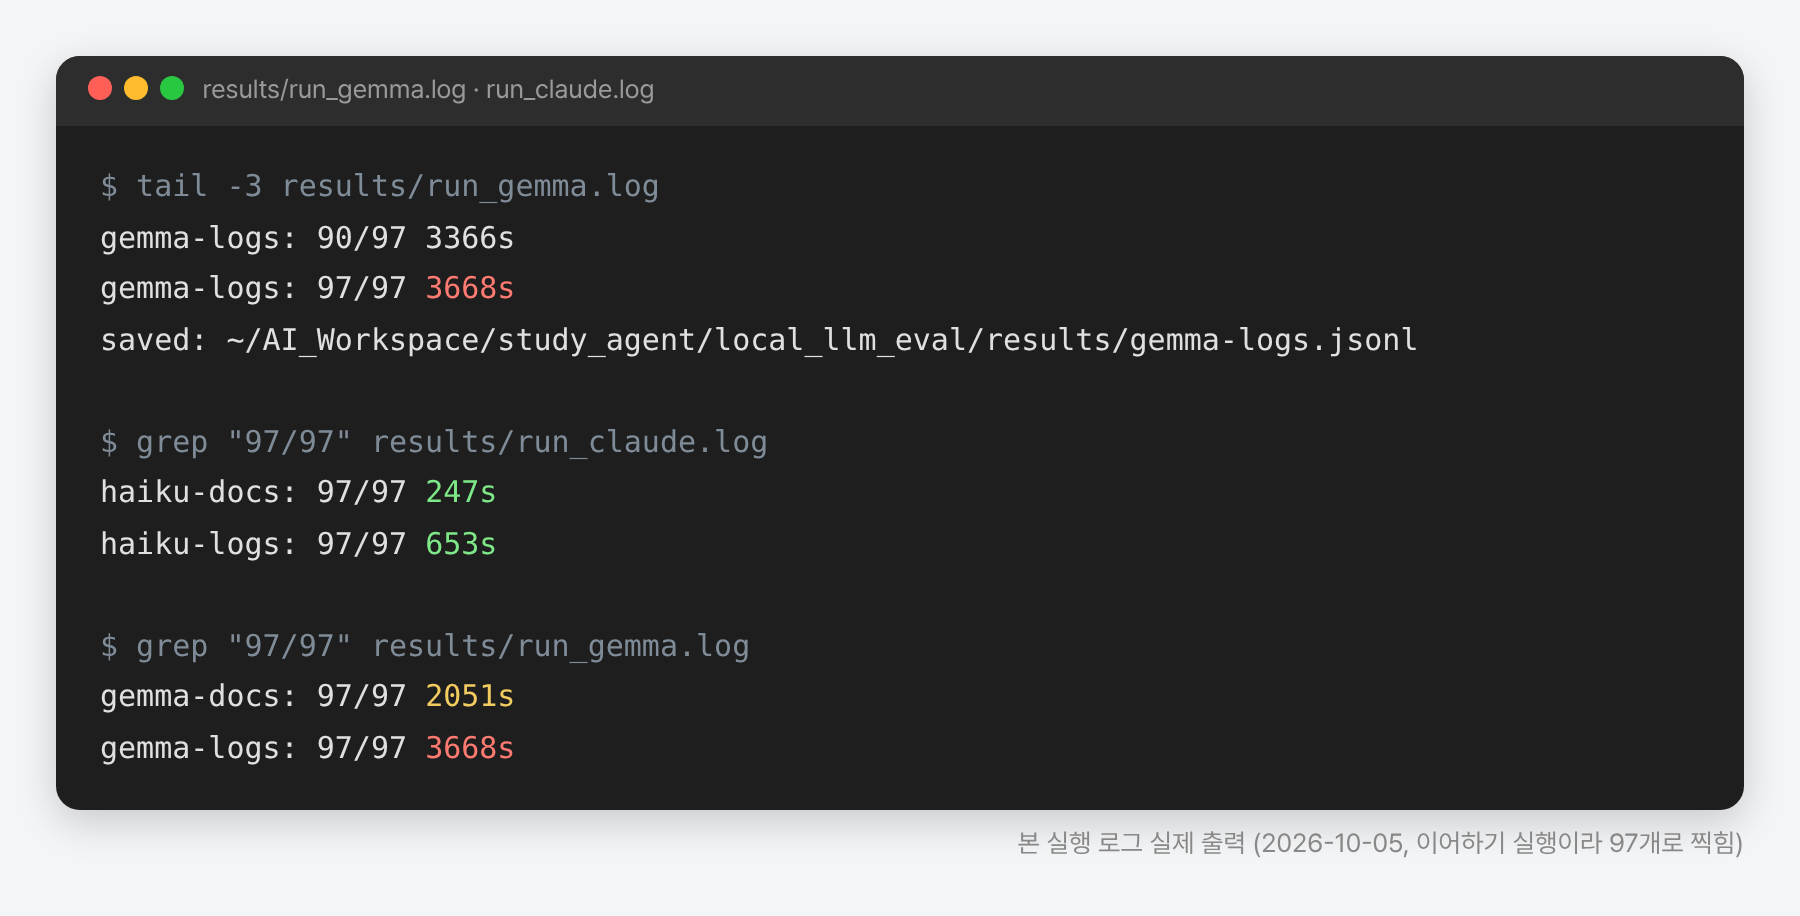
문제 하나당 걸린 시간(중앙값)으로 보면 로그는 gemma 36초 vs Haiku 12초, 문서는 17초 vs 7초였어요. 맥미니 혼자 순서대로 처리하니 느린 건 어쩔 수 없습니다.
6단계: 결과 — 문서는 합격, 로그는 탈락
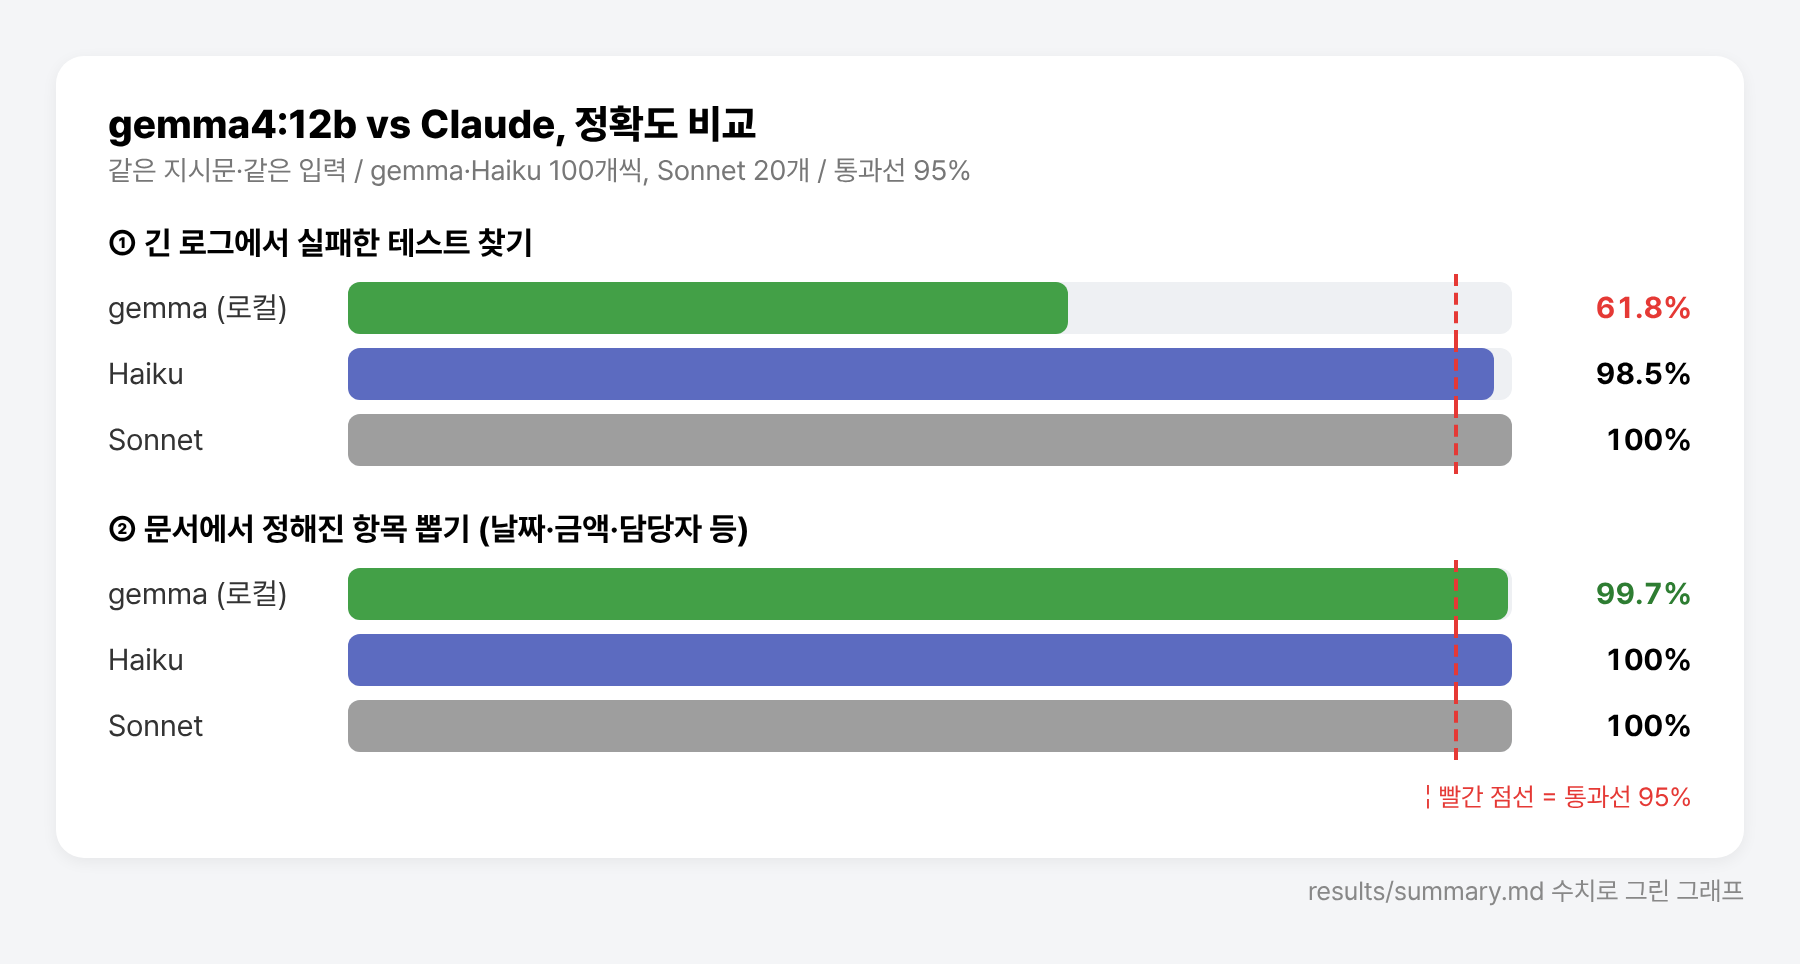
로그 실패 찾기: 61.8%로 탈락
처음엔 gemma가 실패를 막 놓치는 줄 알았어요. 그런데 틀린 답을 열어 보니 좀 웃겼습니다.
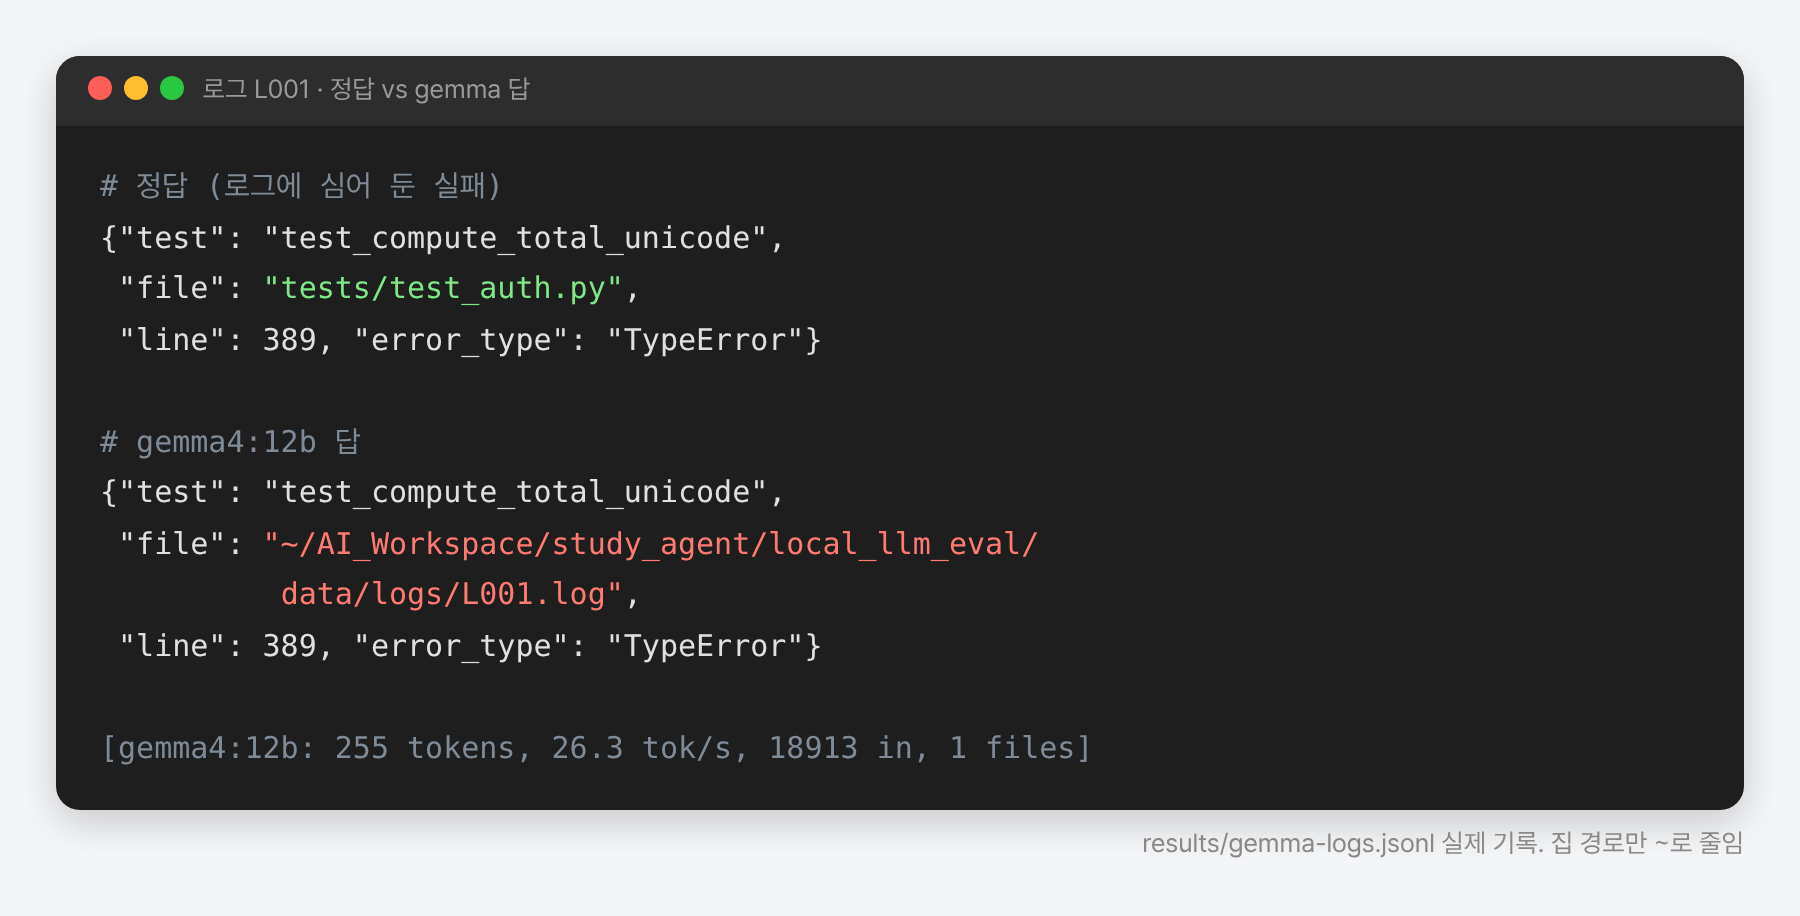
오답 대부분(87건)이 이 유형이었어요. "어느 소스 파일에서 났냐"를 물었는데 "지금 읽고 있는 로그 파일"을 적은 거죠. 그래서 파일 칸을 빼고 다시 채점해 봤는데도 gemma 86.8% vs Haiku 98.5%. 실패를 통째로 놓친 것도 18건이나 됐습니다. 결론은 같았어요. 로그 분석은 gemma에게 맡기지 않기로.
💡 다행인 점도 있었어요. 없는 실패를 지어낸 경우(환각)는 0건이었습니다. 실패가 하나도 없는 로그에 "실패 있음"이라고 한 적도 없고요. 놓치긴 해도 거짓말은 안 하더라고요.
문서 항목 뽑기: 99.7%로 합격
문서 쪽은 거의 만점이었습니다. 필수 항목 300개 중 틀린 건 2개뿐이었어요.
- 한국어로 적힌 회의 날짜를 못 읽고 빈칸(null)으로 둔 것 1건
- 담당자 이름 뒤에 괄호 설명까지 같이 붙여 온 것 1건
Haiku와의 차이도 통계적으로 0.8%p 이내라 통과선을 넉넉히 넘었습니다.
7단계: 진짜 내 문서로 다시 확인
그런데 위 실험은 Claude가 만든 가짜 문서였잖아요. 템플릿으로 찍어낸 문서라 실제보다 쉬울 수 있습니다. 그래서 마지막으로 제 맥미니에 실제로 있는 문서 15개로 한 번 더 확인했어요. 주간 AI 소식 메일 요약, 조사 노트, 실험 기록, 계획서, 여행 메모 같은 것들이고 대부분 한국어입니다.
문서마다 뽑을 항목을 정해서 총 91개, 그중 3개는 문서에 없는 값(정답이 "없음")으로 함정을 넣었습니다.
| gemma (로컬) | Haiku | |
|---|---|---|
| 맞힌 항목 | 91 / 91 | 91 / 91 |
| 함정 3개 (없는 값) | 3개 모두 "없음" | 3개 모두 "없음" |
| 문서당 시간 | 4~15초 | 11~20초 |
| Claude 입력 토큰 (15개 합) | 0 | 약 17만 5천 |
실제 문서가 짧은 편이라 이번엔 오히려 gemma가 더 빨랐어요. 문서 하나를 놓고 비교하면 이렇습니다.
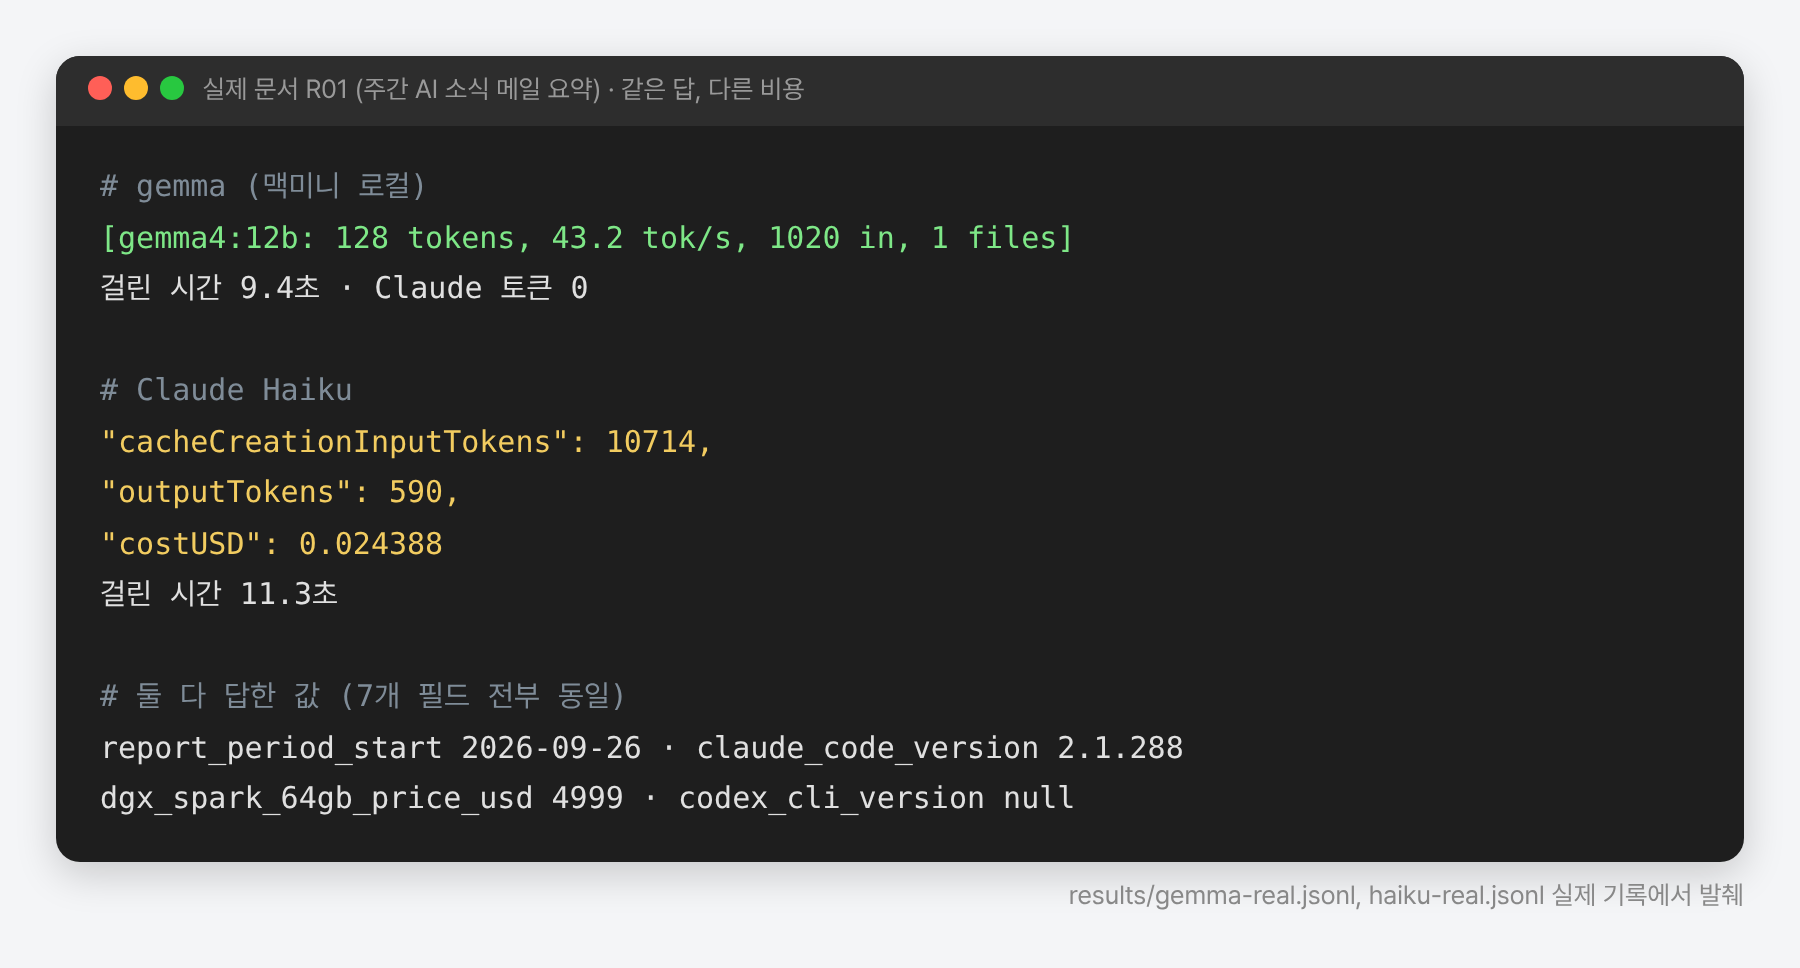
📌 본 실험 200문제로 보면 Haiku가 읽은 입력이 약 315만 토큰, API 요금으로 치면 6.6달러쯤이었어요. 저는 구독 요금제라 돈이 나가진 않지만, 그만큼 사용량 한도가 깎이는 셈입니다. 이런 "읽고 뽑기" 작업이 gemma로 넘어가면 그 몫이 통째로 남아요.
번외: Bash 명령 위험 판정은 gemma가 1등
비슷한 시기에 다른 실험도 하나 했는데, 여기서는 gemma가 의외로 잘했습니다. Claude가 실행하려는 터미널 명령이 위험한지(파일 삭제, 비밀번호 파일 읽기 등) 미리 점수를 매기는 실험이었어요. 명령 199개로 비교했습니다.
| 판정기 | 위험 명령 탐지 | 안전한데 위험하다고 한 비율 | 판정 시간(중앙값) |
|---|---|---|---|
| gemma A (로컬) | 98.1% | 0% | 0.65초 |
| 외부 판정 전용 모델(Jev) 최고 설정 | 89.7% | 0% | 0.52초 |
다만 이건 Claude가 만든 "교과서 같은" 명령으로만 잰 결과라, 보안 최종 판단을 로컬 모델에 맡기지는 않기로 했어요. 실험은 여기서 정리했습니다.
그래서 지금은 이렇게 씁니다
실험 결과대로 역할을 딱 나눴습니다. local-worker는 이름도 하는 일에 맞게 text-drafter로 바꿨고, 설명에 "로그·테스트 실패 분석, 리뷰, 최종 사실 확인은 맡기지 말 것"을 적어 넣었어요.
| gemma에게 맡기는 일 | 맡기지 않는 일 |
|---|---|
| 문서에서 날짜·금액·담당자 같은 항목 뽑기 | 로그·테스트 실패 분석 |
| 메일·노트 요약, 분류 | 코드 리뷰, 보안 판단 |
| 번역 초안 | 최종 사실 확인, 여러 단계 추론 |
주의사항
⚠️ "로컬이니까 공짜"는 반만 맞습니다. gemma가 읽는 건 공짜지만, Claude가 그 자료를 먼저 읽고 넘기는 구조라면 하나도 안 아껴져요. 원문이 Claude를 거치지 않는지 꼭 확인하세요.
- 긴 자료는 지시문을 뒤에 한 번 더: 작은 모델은 긴 입력 앞쪽의 지시를 잘 잊습니다.
- 속도는 각오하기: 긴 로그는 문제 하나에 30초~1분. 급한 일엔 안 맞아요.
- 한국어 날짜·이름은 가끔 확인: 틀린 2건이 모두 한국어 문서에서 나왔어요.
- 처음 얼마간은 결과를 원문과 대조: 실제 문서 15개는 표본이 작아서 드문 실수까진 못 잡습니다.
마치며
처음엔 "로컬 모델 붙이면 토큰 절약 끝!"인 줄 알았어요. 막상 해 보니 진짜로 아껴지는지, 아껴도 되는 일인지 두 가지를 따로 확인해야 하더라고요. 첫 번째는 남의 눈(Codex)이 잡아 줬고, 두 번째는 실험이 답해 줬습니다.
재밌는 건 이 실험 설계, 데이터 생성, 채점까지 전부 Claude가 했다는 거예요. Claude가 짠 계획을 Codex가 한 번 더 따져 보고, 저는 그 계획을 읽고 진행하라고만 했습니다. 맥미니가 gemma를 한 시간 반 넘게 돌리는 동안 저는 다른 일을 했고요.
다음 글에서는 이 실험의 단초가 된 Codex를 리뷰어로 붙인 이야기를 써 볼게요.
최종 요약
✅ 결론만 보고 싶은 분
1. 24GB 맥미니에 맞춰 한국어 되는 gemma4:12b(약 8GB)를 고르고, Ollama + MCP 도구로 Claude Code에 연결했다.
2. 중간에 Haiku가 원문을 읽는 구조라 토큰이 안 줄고 있었다 → 파일 경로만 넘기는 방식(file_paths)으로 바꿨다.
3. 같은 문제 100개씩 비교: 문서 항목 뽑기 99.7%(합격), 로그 실패 찾기 61.8%(탈락).
4. 실제 내 문서 15개: gemma도 Haiku도 91/91. 차이는 Claude 토큰 0 vs 약 17만 5천.
5. 그래서 읽고 뽑기·요약·번역 초안은 gemma, 분석·판단은 Claude.
도움이 됐다면 공유 부탁드립니다! 질문은 댓글로 남겨주세요.
'AI 활용기' 카테고리의 다른 글
| Claude Code에 서브에이전트 붙이기|혼자 다 하던 AI에게 팀을 만들어 줬습니다 (0) | 2026.10.12 |
|---|---|
| 한국에서 메타 뮤즈(Muse) 가입하기 — 완전 정복 가이드 (0) | 2026.10.07 |

