📌 이 글은 Claude Code의 서브에이전트를 값이 10분의 1인 새 Haiku 5.5로 바꿔도 되는지 30번 돌려 본 기록입니다. 결론부터 말하면, 싼 모델이 꼭 싸지는 않았어요. 결론만 궁금하시면 맨 아래 최종 요약으로 가셔도 됩니다.
지난번에 Claude Code에 서브에이전트를 붙여서 코드 찾는 애(Explore), 테스트 돌리는 애(test-runner, 지금은 qa로 이름이 바뀌었어요) 같은 팀원을 만든 얘기를 했죠. 그 글엔 못 적었는데, 이 가벼운 팀원들은 처음에 Haiku로 두었다가 Sonnet으로 바꿨어요. 그런데 10월 7일에 Claude Haiku 5.5가 나왔는데, 값이 이전 Haiku의 10분의 1이래요. 이러면 다시 Haiku로 돌아가는 게 맞지 않을까? 궁금해서 붙여 봤습니다.
📎 궁금하신 분들은 지난 「Claude Code에 서브에이전트 붙이기|혼자 다 하던 AI에게 팀을 만들어 줬습니다」 포스팅을 참고하세요 → 글 보러 가기
왜 다시 시험했나?
10월 2일에 한 번 비교한 적이 있어요. 그때는 이전 Haiku(4.5)와 Sonnet을 같은 문제로 돌렸는데, 정답은 둘 다 같았고 Sonnet이 토큰을 20~47% 덜 쓰고 2~4배 빨랐어요. 그래서 팀원들을 Sonnet으로 바꿨죠.
그런데 모델이 새로 나왔고, 값이 확 내려갔어요. Haiku 5.5는 100만 토큰당 입력 0.10달러, 출력 0.50달러예요. "이 정도면 토큰을 좀 더 써도 이득 아냐?" 싶었죠.
1단계: 정답이 정해진 문제 5개 만들기
비교하려면 "맞았다/틀렸다"가 분명해야 해요. 그래서 제가 쓰는 AI 사용량 위젯 프로젝트의 코드를 한 시점으로 고정해 두고, 정답을 미리 확인한 문제 5개를 만들었어요.
- 코드 찾기 3세트(Explore): 세트마다 질문 3개. 예를 들면 "실시간 갱신 주소가 어느 파일 몇 번째 줄에 있어?", "설정 고치기 전에 백업하는 함수 이름은?" 같은 거예요.
- 테스트 돌리기 2개(test-runner): 일부러 틀린 연습용 테스트 6개, 그리고 실제 위젯 테스트 430개.
문제 5개를 모델마다 3번씩, 그러니까 모델당 15번, 합쳐서 30번 돌렸어요. 같은 회차의 두 모델은 같은 조건에서 동시에 띄웠고요. 전역 설정은 건드리지 않고, 서브에이전트를 부를 때 모델만 바꿔 지정했어요.
2단계: 30번 돌린 결과
| 과제 | 모델 | 정답 | 평균 토큰 | 도구 호출 |
|---|---|---|---|---|
| 코드 찾기 A | Haiku 5.5 | 9/9 | 29,654 | 7.7 |
| 코드 찾기 A | Sonnet 5.5 | 9/9 | 17,799 | 3.7 |
| 코드 찾기 B | Haiku 5.5 | 8/9 | 29,052 | 7.3 |
| 코드 찾기 B | Sonnet 5.5 | 9/9 | 22,016 | 5.3 |
| 코드 찾기 C | Haiku 5.5 | 9/9 | 28,462 | 9.0 |
| 코드 찾기 C | Sonnet 5.5 | 9/9 | 21,954 | 3.0 |
| 테스트 430개 | Haiku 5.5 | 3/3 | 12,081 | 2.0 |
| 테스트 430개 | Sonnet 5.5 | 3/3 | 12,008 | 2.0 |
합치면 정답은 Haiku 5.5 32/33, Sonnet 5.5 33/33이에요. 거의 비슷하죠. 그런데 코드 찾기에서는 그림이 달랐어요.
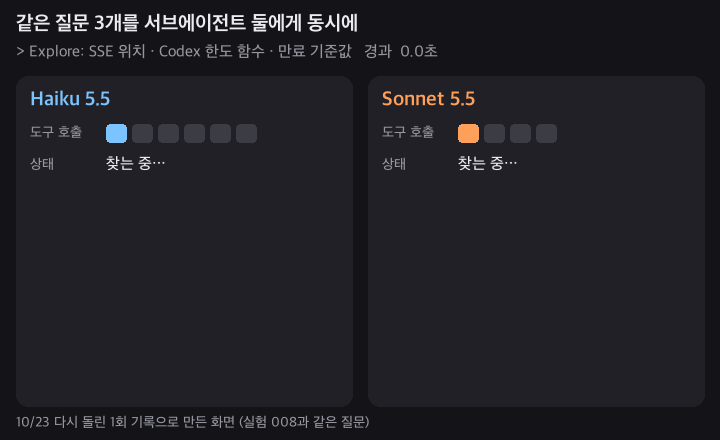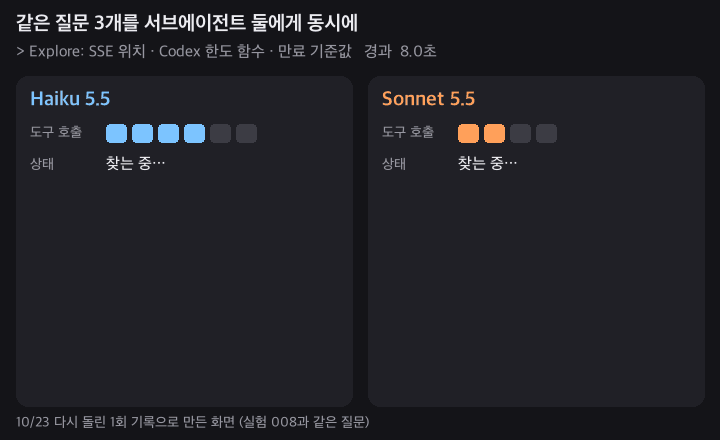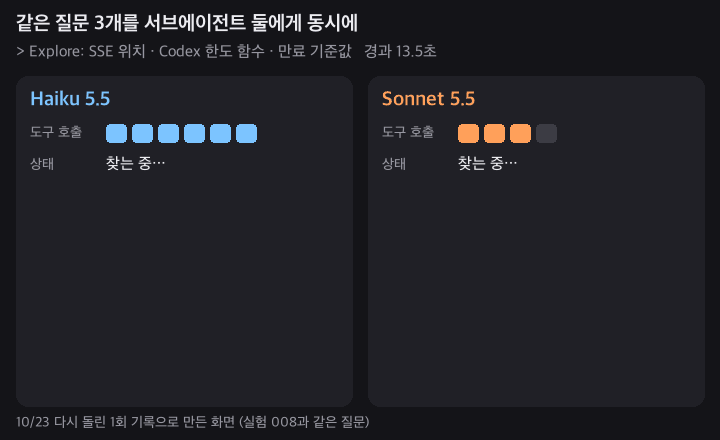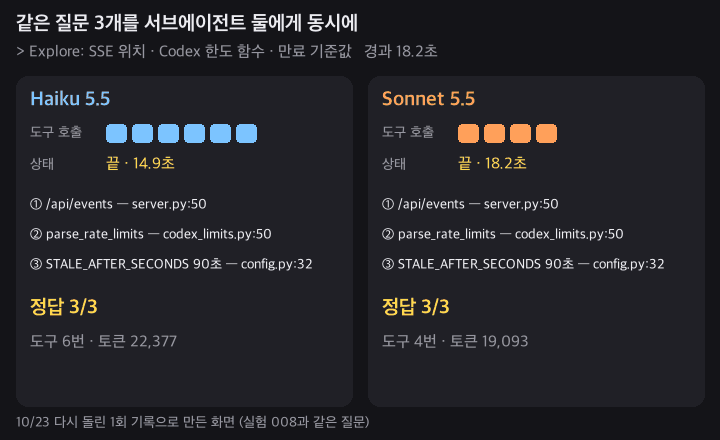
- 토큰: Haiku가 평균 약 1.4배(28~67% 더) 썼어요.
- 도구 호출: 약 2배. 여기저기 더 뒤져 보고 나서야 답을 찾는 느낌이에요.
- 틀린 1건: "백업 함수 이름" 질문에서 엉뚱한 폴더의 비슷한 함수를 답하고, 정답 폴더에는 "그런 거 없다"고 단정했어요. 같은 질문을 다른 회차에선 맞혔고요.
반대로 테스트 돌리기는 정답·토큰·도구 호출·시간이 사실상 똑같았어요. 테스트가 왜 실패했는지(함수가 아니라 테스트 기대값이 틀렸다는 점) 설명도 둘 다 정확했어요.
삽질 하나: 1회차가 전부 8분 반씩 멈췄다
1회차에 띄운 10개가 모두 첫 명령어 실행에서 약 8분 반을 기다렸어요. 모델이 느린 게 아니라 명령 실행 차례를 기다린 것으로 보이는데, 원인은 끝내 못 찾았어요.
이대로 "걸린 시간"을 비교하면 엉터리가 되잖아요. 그래서 서브에이전트 기록에 남은 시각을 보고, 모델이 실제로 답을 만드는 데 쓴 시간만 따로 더해서 비교했어요. 그렇게 보니 코드 찾기에서 Haiku가 Sonnet보다 같거나 오래 걸렸어요(예: C세트 21.3초 vs 12.9초).
그래서 어떻게 했나
- 코드 찾기(Explore): Sonnet 그대로. 틀린 게 1건 있었고, 토큰과 도구 호출도 더 많았어요. 값이 10분의 1이어도 토큰을 1.4배 쓰고 두 번 더 뒤지면 "싸다"고 말하기 어렵더라고요.
- 테스트 돌리기: 바꿔도 품질 차이는 없음. 다만 실제로 사용량이 얼마나 줄어드는지는 확인하지 못해서 바로 바꾸진 않았어요.
솔직히 한계도 있어요. 과제마다 3번씩이라 틀린 1건이 우연인지 경향인지 단정할 수 없고, 토큰은 입력·출력 합계라 정확한 비용 계산은 못 했어요. Sonnet 5.5 값과 요금제 한도에서 모델별로 얼마나 깎이는지도 확인하지 않았고요.
그래도 한 가지는 분명했어요. "값이 싼 모델"과 "일을 싸게 끝내는 모델"은 다르다는 것. 특히 코드를 찾아 헤매는 일처럼 몇 번을 뒤지느냐가 비용을 정하는 일에서는요. 그럼 이 서브에이전트들을 실제 과제에서는 얼마나 부를까요? (그때) 서브에이전트 7개를 꾸민 제 환경과 기본 상태를 같은 과제로 붙여 봤더니, 실제로 불린 건 리뷰어 하나뿐이었어요.
📎 궁금하신 분들은 지난 「내 Claude Code 환경 vs 기본 상태, 같은 과제로 붙여 봤다」 포스팅을 참고하세요 → 글 보러 가기
최종 요약
✅ 결론만 보고 싶은 분
1. Haiku 5.5(값은 이전 Haiku의 1/10)와 Sonnet 5.5를 서브에이전트로 30번 비교.
2. 정답 32/33 vs 33/33. 코드 찾기에서 Haiku는 토큰 약 1.4배, 도구 호출 약 2배, 틀린 것 1건.
3. 테스트 돌리기는 정답·토큰·시간 사실상 같음.
4. 1회차 8분 반 대기 사고 → 모델이 실제로 답한 시간만 따로 계산.
5. 코드 찾기는 Sonnet 유지. "싼 모델"이 "싸게 끝내는 모델"은 아니었다.
도움이 됐다면 공유 부탁드립니다! 서브에이전트 모델 어떻게 고르시는지 댓글로 알려 주세요.


