📌 이 글은 맥미니(메모리 24GB)에 올려 둔 로컬 LLM gemma4:12b를 3주 동안 실제로 언제 썼는지 기록을 뒤져 보고, 다시 재 본 기록입니다. 결론부터 말하면, 제 맥미니 사양에선 평소에 쓰기엔 너무 느리고, Claude 한도가 떨어진 날 꺼내 쓰는 보험이에요. 결론만 궁금하시면 맨 아래 최종 요약으로 가셔도 됩니다.
요즘 쓰레드에서 "근데 로컬 LLM 다들 많이 써? 쓸 만한 수준이야?" 같은 글이 자주 보여요. 맥미니나 맥스튜디오로 로컬 AI 돌려 본 후기를 묻는 글도 많고요. 저도 3주 전에 맥미니에 gemma를 올리고 Haiku랑 정확도를 붙여 봤었죠. 그때는 "문서에서 항목 뽑기는 합격, 로그에서 실패 찾기는 불합격"이었어요.
📎 궁금하신 분들은 지난 「로컬 LLM(Ollama gemma)으로 Claude 토큰 아끼기|맥미니에 gemma4 올리고 Haiku랑 정확도 붙여 본 기록」 포스팅을 참고하세요 → 글 보러 가기
그 뒤 3주 동안 실제로 언제 꺼내 썼는지 기록을 뒤져 보고, 같은 측정을 다시 돌려 봤어요. 돌리는 동안 메모리도 같이 기록했고, 전기료는 애플 공식 자료로 계산했어요.
1. 3주 동안 언제 꺼내 썼나
제가 직접 시킨 건 0번이에요(10월 6일~20일 기준). 이 기간에 Claude가 로컬 모델 도구(ask_local_llm)를 부른 기록이 한 번도 없었어요. 문서에서 날짜·버전 같은 항목만 뽑을 땐 로컬로 보내라고 규칙까지 적어 뒀는데도요.
대신 비상용으로는 두 번 일했어요. 제 미국 주식 뉴스 정리 작업은 Claude 호출이 실패하면 로컬 모델이 대신 하도록 만들어 뒀거든요.
| 날짜 | 무슨 일 | 로컬 모델이 맡은 뉴스 평가 |
|---|---|---|
| 10/12 | Claude 호출이 오류로 실패 | 379건 중 342건 |
| 10/25 | Claude 주간 한도 소진(10/24 오후~10/26 오후) | 357건 중 357건 전부 |
특히 10/25가 컸어요. 그 주말엔 Claude 주간 한도가 바닥나서 블로그 예약 글도, 쓰레드 게시도 다 멈췄는데, 뉴스 정리만은 로컬 모델 덕분에 그날 몫을 처리했어요. 평소 같은 일을 Sonnet 5.5가 하면 뉴스 1건에 입력 약 4,500·출력 약 2,150토큰을 써요. 357건이면 약 238만 토큰어치를 로컬이 대신한 셈이에요(평균으로 낸 추정이에요).
2. 지금 다시 재 보니
3주 전과 똑같은 측정 도구로, 제 맥에 있는 실제 문서 15개(보고서 메일, 실험 기록, 작업 내역 등)에서 사실 91개를 뽑게 다시 시켜 봤어요.
| 항목 | 10/6 (첫 측정) | 10/27 (다시) |
|---|---|---|
| 같은 14개 처리 시간 (파일 옮긴 1개 빼고) |
89.6초 | 105.3초 |
| 문서 1개당(중간값) | 약 6.0초 | 약 6.4초 |
| 정답 | 91개 중 91개 | 91개 중 83개 → 실제 오답 1개 |
83개만 보고 놀랐는데, 틀린 8개를 하나씩 열어 보니 이랬어요.
- 📁 6개: 그사이 원문 파일을 다른 폴더로 옮겨서 "파일이 없다"로 끝남. 모델 잘못이 아님
- 📅 1개: 그 문서가 그사이 늘어나서, 모델이 말한 "최신 날짜"가 지금 기준으로는 맞음. 정답표가 낡은 것
- 📅 1개: 같은 문서에서 "Codex 메인 모델"을 물었는데, 처음 정답표는 Astra였지만 10/17에 Sol로 바뀐 기록이 그 뒤에 추가됨. 모델 답(Sol)이 지금 기준으로는 맞음
그런데 지금 원문 기준으로 다시 보니 하나가 더 걸렸어요. Codex 역할 수를 7개라고 답했는데, 그 문서엔 나중에 planner 역할이 하나 추가돼 지금은 8개예요. 채점할 수 있는 85개로 치면 84개 정답(약 99%)이에요. 실제 문서는 원문이 계속 바뀌어서, 3주 전 정답표를 그대로 쓰면 맞는 답도 틀린 걸로 나와요. 속도는 같은 14개로 비교하면 89.6초에서 105.3초로 약 17% 느려졌어요. 이번엔 다른 세션들이 메모리를 같이 쓰고 있었던 영향일 수도 있는데, 이번 측정으로는 구분이 안 돼요. 문서에서 항목 뽑기는 여전히 쓸 만해요.
3. 대신 메모리 여유가 줄어든다
이번엔 돌리는 동안 2초마다 메모리도 기록해 봤어요(관리자 권한 없이 볼 수 있는 숫자만).
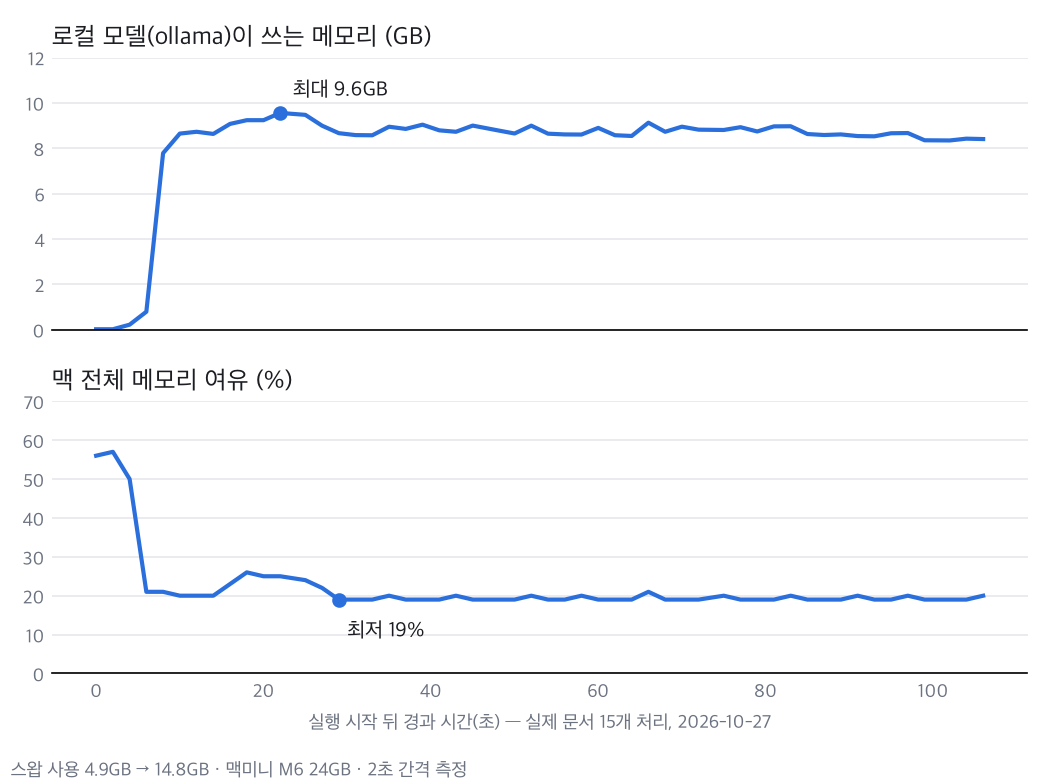
- 🧠 로컬 모델(ollama)이 최대 약 9.6GB
- 📉 맥 전체 메모리 여유 57% → 19%
- 💾 스왑(메모리가 모자라 SSD를 대신 쓰는 것) 약 4.9GB → 14.8GB
💡 스왑이 늘어난 게 전부 gemma 때문인지는 따로 가리지 않았어요. 그 시간에도 제 맥미니엔 AI 세션 여러 개와 예약 작업이 같이 떠 있었거든요. 다만 로컬 모델이 도는 동안 맥 전체 여유가 20% 아래로 내려가 있었던 건 그래프에 그대로 찍혀 있어요.
제가 쓰레드에서 "램 24GB로는 만족할 성능이 어렵다"고 했던 게 이 느낌이에요. 3주 전에도 28GB짜리 더 큰 모델은 스왑 때문에 포기했었고요. 그래프를 보면 측정 시작 8초 뒤에 이미 약 7.8GB를 쓰고 있었어요.
4. 전기료는 얼마나 들까
전기료는 애플 공식 자료로 추정했어요. 제 맥미니(M6)와 같은 칩의 공식 소비전력은 쉴 때 4W, 최대 70W예요(애플 지원 문서, 16GB 구성 기준). 넉넉하게 최대 70W로 계속 돌았다고 쳐도:
| 경우 | 걸린 시간(추정) | 전기(최대 기준) | 전기료(1kWh 307.3원 가정) |
|---|---|---|---|
| 실제 문서 14개 | 105.3초 | 약 2Wh | 1원 미만 |
| 10/25 뉴스 357건 | 약 45분(문서 1개 7.5초로 가정) | 약 52Wh | 약 16원 |
전기료 단가는 한전 주택용 요금 중 가장 비싼 구간(2023년 11월 적용표 기준, 월 400kWh 초과)을 그대로 썼어요. 같은 15개 문서를 Haiku로 하면 약 0.26달러(약 18만 7천 토큰)였으니, 보험으로 가끔 돌리는 전기료는 거의 신경 쓸 게 없어요.
다만 저는 Claude를 구독으로 써서, 로컬로 돌려도 통장에 남는 돈은 없어요. 아껴지는 건 주간 한도뿐이에요. 솔직히 토큰이 넉넉할 땐 로컬 LLM을 직접 꺼내 쓰지 않게 돼요. 제 맥미니(24GB)에서는 너무 느리거든요.
5. 그래서 제 결론: 보험이다
- ❌ 평소엔: 너무 느리고 메모리 여유가 확 줄어서, 24시간 여러 AI가 돌아가는 맥미니에선 일부러 쓰지 않게 돼요(10/6~20 직접 호출 0번).
- ✅ 한도가 떨어진 날엔: Claude가 멈춘 10/25에 뉴스 357건을 대신 처리했어요. 평소엔 잊고 있다가 이런 날 꺼내 쓰는 보험이에요.
- ✅ 보험으로 맡기는 일: 문서에서 항목 뽑기는 여전히 잘해요(3주 전 100문제 실험 99.7%, 이번 실제 문서는 85개 중 84개). 로그에서 실패 찾기처럼 판단이 필요한 일은 맡기지 않아요.
최종 요약
📌 한 줄 결론: 맥미니 24GB에서 로컬 LLM은 평소엔 너무 느려서 안 쓰고(10/6~20 직접 사용 0번), Claude 한도가 떨어진 날 꺼내 쓰는 보험이에요(비상용 2번).
• 쓴 기록: 직접 시킨 건 10/6~10/20 0번, 비상용으로 10/12 342건·10/25 357건(주간 한도 소진일)
• 다시 잰 정확도: 실제 문서 15개, 채점 가능한 85개 중 84개 정답(약 99%, 지금 원문 기준), 같은 14개 처리는 89.6초→105.3초로 약 17% 느려짐
• 메모리: 모델이 약 9.6GB, 맥 여유 57%→19%, 스왑 4.9→14.8GB
• 전기료: 최대 70W로 쳐도 357건에 약 16원(추정). 돈보다 속도와 메모리가 문제
• 추천: 24GB면 한도 떨어졌을 때 "항목 뽑기" 같은 단순한 일을 맡기는 보험까지. 판단이 필요한 일은 Claude에게
· · ·
도움이 됐다면 공유 부탁드립니다! 로컬 LLM 어디에 쓰고 계신지 댓글로 알려 주세요.
'토큰탕진 실험실' 카테고리의 다른 글
| 싼 모델 Haiku 5.5로 서브에이전트 바꿔도 될까?|30번 돌려 보니 싼 게 꼭 싸지는 않았다 (0) | 2026.10.23 |
|---|---|
| Aside·ego-lite, Claude Code에 이틀 붙여 본 종합|WebFetch·Chrome까지 상황별로 뭘 쓰나 (0) | 2026.10.22 |
| 요즘 핫한 Aside, Claude Code에 붙여 하루 써 봤다|Chrome보다 느린데 계속 쓰는 이유 (0) | 2026.10.21 |
| 내 Claude Code 환경 vs 기본 상태, 같은 과제로 붙여 봤다|서브에이전트 7개 중 일한 건 1개 (0) | 2026.10.16 |
| 로컬 LLM(Ollama gemma)으로 Claude 토큰 아끼기|맥미니에 gemma4 올리고 Haiku랑 정확도 붙여 본 기록 (0) | 2026.10.13 |


