📌 쓰레드에서 "10월 기준 쓸만한 로컬 LLM" 순위 글을 보고, 그 모델들이 제 24GB 맥미니에서 진짜 돌아가는지 재 봤어요. 조건은 하나, 스왑(메모리가 모자라 디스크를 대신 쓰는 것) 없이. 이 조건 때문에 네 번을 다시 쟀고, 결국 살아남은 건 둘이에요. 결론만 궁금하시면 맨 아래 최종 요약으로 가셔도 돼요.
시작은 쓰레드 순위 글이었어요. 1위 DeepSeek v4.1 Flash부터 GLM 5.3 Flash, Qwen3.8, Gemma4, GPT-OSS까지 여섯 개가 올라와 있었고, 답글에서는 "최소 사양이 뭐냐", "토큰 속도는 얼마나 나오냐"를 묻는데 실제로 재 본 숫자는 안 보이더라고요.
🔗 참고한 글: @slamslam__ 「2026년 10월 기준 로컬 LLM 순위」 → 쓰레드에서 보기
저는 이미 로컬 모델을 "Claude 한도가 떨어진 날 꺼내 쓰는 보험"으로 쓰고 있어요. 그때 쓰던 게 gemma4 12b였는데, 순위에 있는 더 큰 모델로 바꿀 수 있는지가 궁금했어요.
📎 지난 글: 로컬 LLM은 보험이다 · 로컬 LLM으로 토큰 아끼기
1. 무엇을, 무엇과 비교했나
순위 여섯 개 중 맥미니 24GB에 올라갈 수 있는 것부터 골랐어요. 모델 크기는 공식 모델 카드와 Ollama 태그에 적힌 값이에요.
| 순위 글 이름 | 맥미니 24GB에서 | 실제로 받은 모델 |
|---|---|---|
| DeepSeek v4.1 Flash | ❌ Ollama엔 클라우드 태그만 | - |
| GLM 5.3 Flash | ❌ 클라우드만 | - |
| Qwen3.8-Flash-Next | ❌ 최소 105GB | - |
| Qwen3.8-27B | ⚠️ 경계선(18GB) | qwen3.8:27b |
| Gemma4 | ✅ 12B / ⚠️ 26B | gemma4:12b, gemma4:26b-a4b-it-qat |
| GPT-OSS | ✅ 20B | gpt-oss:20b |
과제는 두 가지예요. 정답을 코드로 미리 계산해 두고 답을 자동으로 채점했어요.
- 🧾 로그 실패 추출: 테스트 로그에서 실패한 테스트 이름·파일·줄·오류 종류를 뽑아 JSON으로 답하기.
- 💳 지출 정산: 한글·영어가 섞인 월 지출표에서 정정·환불·달러 환산까지 반영해 합계와 최다 지출처 구하기.
Claude는 Haiku 5.5와 Sonnet 5.5를 노력 수준(low·medium·high)별로 같은 문제에 돌렸어요. "로컬 모델이 Claude의 어느 수준쯤이냐"를 보려고요. Opus는 이 비교엔 과해서 뺐어요.
2. 제일 어려웠던 건 "스왑 없이" 재는 것
측정 전에 정한 조건이 있었어요. "로컬모델을 사용시에는 스왑이 최대한 일어나지 않는 상태에서 평가해야해." 스왑이 끼면 느린 게 모델 탓인지 디스크 탓인지 알 수 없거든요. 그래서 설정마다 스왑이 기준(처음엔 100MB, 2차부터 1GB)을 넘으면 그 설정은 멈추고 "스왑 영향"으로 표시하게 했어요. 이 조건 하나 때문에 네 번을 다시 쟀어요.
1차 새벽: 제일 큰 모델을 먼저 돌렸다가 전부 오염
다른 작업이 없는 새벽에 돌리면 깨끗할 줄 알았어요. 경계선인 qwen3.8 27b를 먼저 확인하자며 첫 순서에 뒀는데, 18GB 중 21%가 GPU에 못 올라가고 CPU로 넘어갔어요. 문제 하나에 10분이 넘어 시간 초과, 그 사이 디스크로 밀려난 데이터가 171GB였어요. 모델은 내렸지만 맥이 회복하기 전에 다음 모델들이 시작돼서, 나머지 다섯 설정도 전부 스왑으로 멈췄어요.
2차 아침: 작은 모델부터, 큰 모델은 맨 끝으로
"큐웬을 마지막순서로 다시해봐." 순서를 바꾸고, 설정과 설정 사이마다 맥이 회복됐는지 다시 확인하고 시작하게 고쳤어요. 이번엔 원인이 깔끔하게 갈렸어요. gemma4 12b(생각 켬)는 22문제 동안 스왑 0이었는데, 나머지 설정은 모델을 메모리에 올리는 첫 문제에서 1.4~3.4GB를 밀어냈어요. 켜 둔 앱들이 이미 메모리를 차지하고 있었거든요.
3차 오전: 앱을 다 닫고
켜 둔 앱을 정리하고 재 보기로 했어요. 시뮬레이터·Xcode·VS Code 같은 큰 앱을 닫고 여유 메모리 78%에서 다시 쟀어요. gemma4 12b는 거의 모든 문제를 스왑 없이 끝냈지만, gpt-oss 20b와 gemma4 26b는 여전히 첫 문제(모델을 올리는 문제)에서 1.6~3.6GB 스왑이 났어요. qwen3.8 27b는 세 번째로 같은 결과였고요(문제 하나 250초, 스왑 38GB). 그런데 나중에 보니 이 두 모델을 잴 때 다른 작업이 아이폰 시뮬레이터를 다시 켜 두었고 위젯 서버도 CPU를 46~62% 쓰고 있었어요. 그래서 둘만 한 번 더 쟀어요.
4차 낮: "올릴 때 스왑"과 "푸는 중 스왑"을 나눠서
모델을 올리는 첫 문제에서 한 번 밀어내는 건 어쩔 수 없다 치고, 그 뒤 문제를 푸는 동안 스왑이 나는지를 따로 봤어요(첫 문제에는 모델 올리기와 첫 답 만들기가 같이 들어 있어서, 둘을 완전히 나눈 건 아니에요). 여기서 갈렸어요.
- gpt-oss 20b: 첫 문제에서 2.2GB 한 번. 그 뒤 15문제 중 12문제는 스왑 0. 마지막에 1GB가 났는데 마침 다른 예약 작업(웹 브라우저 자동화)과 겹친 시간이었어요.
- gemma4 26b: 문제를 푸는 중에도 0.6~4.3GB씩 스왑. 14GB 모델은 이 맥에서 빠듯해요.
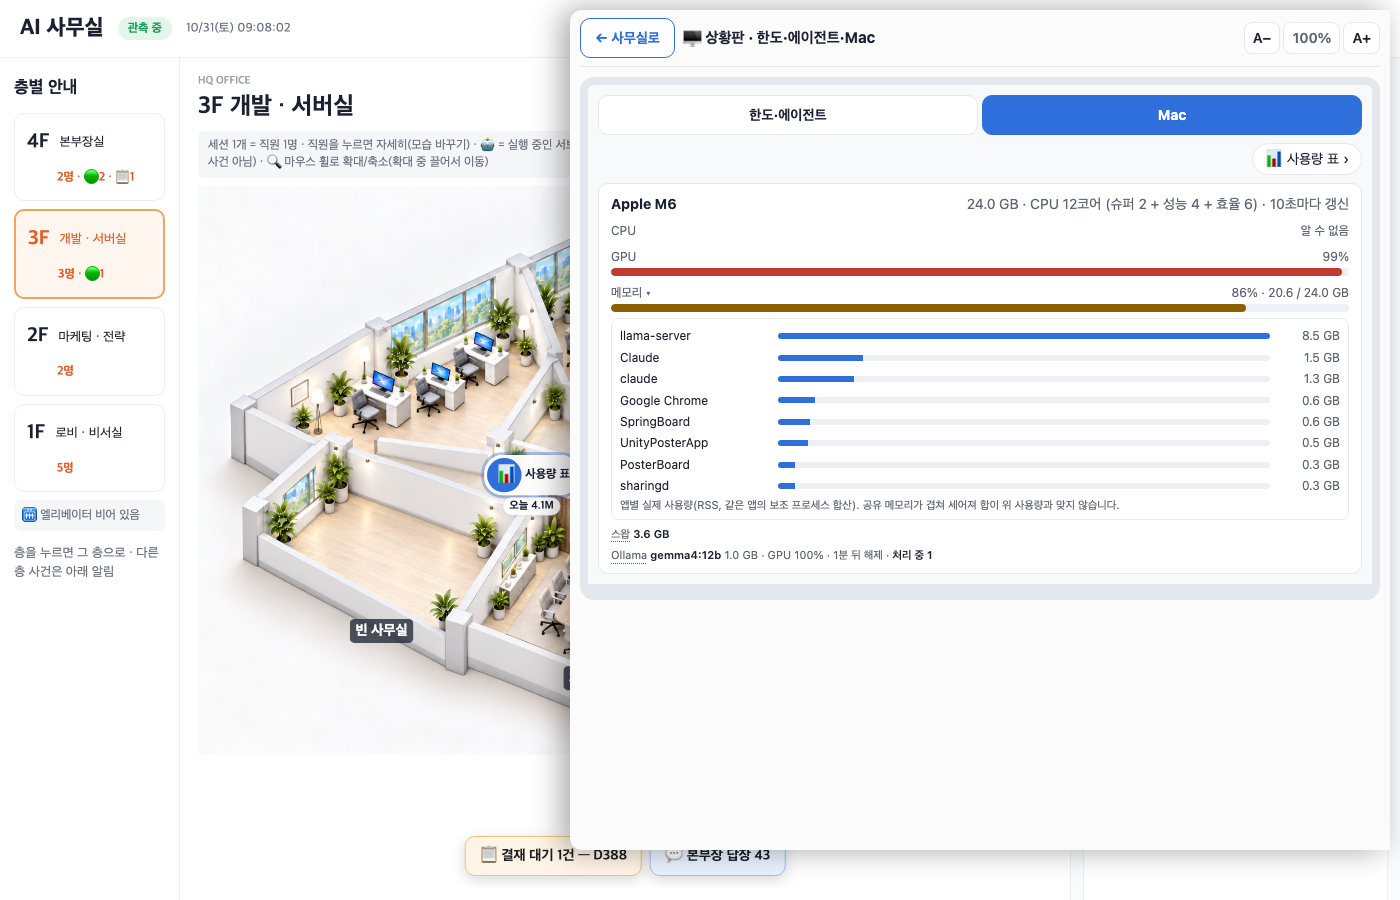
하나 더 배운 게 있어요. Ollama의 ollama ps는 gemma4 12b를 1.0GB라고 보여 주는데, 위젯 상황판으로 보면 실제 모델 프로세스(llama-server)는 8.5GB를 쓰고 있었어요. "몇 GB짜리 모델"이라는 숫자만 보고 메모리를 계산하면 안 되더라고요.
3. 결과: 시간·토큰·가격·품질
로그 실패 추출 과제에서 디스크로 밀어낸 스왑(swapout)이 0인 문제만 모았고, 그중 Claude도 푼 문제끼리 비교했어요. 디스크에서 다시 읽어 들인 양(swapin)은 조금 남아 있어요(gpt-oss 12문제 합계 약 0.7GB). 로컬 모델끼리도 문제 수가 달라서 숫자를 1:1로 견주기보다는 경향으로 봐 주세요.
| 문제 수 | 품질 | 문제당 시간(중앙값) | 출력 토큰 | 문제당 가격 | |
|---|---|---|---|---|---|
| gpt-oss 20b | 12 | 89% | 36초 | 약 1,100 | 전기 약 0.2원 |
| gemma4 12b (생각 끔) | 18 | 61% | 30초 | 약 220 | 전기 약 0.15원 |
| gemma4 12b (생각 켬) | 19 | 63% | 105초 | 약 2,700 | 전기 약 0.6원 |
| Claude Haiku 5.5 | 20 | 95% | 약 8초 | 약 800~1,100 | 약 $0.001~0.003 |
| Claude Sonnet 5.5 | 20 | 100% | 약 7초 | 약 200~300 | 약 $0.009 |
| gemma4 26b / qwen3.8 27b | - | 스왑 때문에 판정 못 함 | - | - | - |
- 전기는 맥미니 최대 소비전력 70W × 평균 시간 × 한전 2단계 요금(kWh당 257.6원)으로 어림한 값이에요. 70W는 공식 페이지의 16GB 구성 값이라 24GB엔 근사치이고, 오래 걸린 문제(최대 404초)는 2원쯤 들어요.
- Claude 가격은 API 공식 단가로 환산한 참고값이에요. 저는 구독으로 쓰니 실제로는 한도를 쓰는 거고요.
- 지출 정산 과제는 gemma4 12b(생각 끔)만 6문제를 스왑 없이 끝냈는데 53%, 합계 금액은 하나도 못 맞혔어요. Claude는 Haiku·Sonnet 모두 98~100%였어요.
Claude의 어느 수준쯤일까
gpt-oss 20b가 푼 12문제를 Claude도 똑같이 풀었을 때, Haiku low·high는 92%, Haiku medium과 Sonnet은 100%였어요. 숫자만 보면 gpt-oss 20b(89%)는 Haiku low·high(92%) 바로 아래예요. 하지만 12문제뿐이라 차이의 95% 구간이 −28%p~+22%p로 넓어서, Claude의 어느 노력 수준과 같다고는 말할 수 없어요. 처음 정한 기준(구간 전체가 ±10%p 안)에 한참 못 미쳐요. gemma4 12b는 Claude 어느 설정보다도 30%p 넘게 아래였고요.
4. 그래서 우리도 바꿨어요
- 평소엔 Claude. 같은 문제를 4~14배 빨리, 더 정확하게 풀어요.
- 로컬은 여전히 보험. Claude 한도가 떨어진 날 꺼내 쓰는 용도는 그대로예요.
- 보험 모델은 gemma4 12b → gpt-oss 20b로. 품질 차이가 커서 우리 대체 모델 기본값을 gpt-oss 20b로 바꿨어요. 메모리가 빠듯한 날만 gemma4 12b를 써요.
- 안 쓰는 모델은 지움. qwen3.8 27b와 gemma4 26b는 지워서 디스크 31GB를 되찾았어요.
⚠️ 이 측정에 대해
- 과제 2개, 문제 20~30개, 한 번씩만 돌린 결과예요. 로컬 모델은 스왑이 난 문제를 빼서 문제 수가 더 적어요(gpt-oss 12개, gemma4 12b 18~19개).
- 과제와 채점기는 Claude가 만들었고, 정답은 사람이 아니라 코드로 계산한 값이에요.
- 로컬 모델은 seed 42·기본 온도, Claude는 온도를 정할 수 없어요. Ollama 0.35.1 기준이에요.
- Sonnet low는 먼저 돌아서 캐시 쓰기 비용을 혼자 냈기 때문에 문제당 약 $0.07로 튀었어요. 위 표에서는 뺐어요.
- 24GB 맥미니에서 Claude 앱과 세션 몇 개는 켜 둔 상태예요. 앱을 다 끄면 결과가 조금 달라질 수 있어요.
마치며
순위 글의 1~3위는 처음부터 맥미니에 올라가지도 않았고, 올라가는 것 중에서도 스왑 없이 버틴 건 gpt-oss 20b와 gemma4 12b뿐이었어요. 모델 성능보다 "내 맥에서 다른 앱이랑 같이 돌아가느냐"가 먼저더라고요. 네 번이나 다시 재느라 반나절이 갔지만, 덕분에 보험 모델을 바꿀 근거는 확실히 생겼어요.
최종 요약
✅ 결론만 보고 싶은 분
1. 쓰레드 로컬 LLM 순위 6개 중 24GB 맥미니에 올라가는 건 gemma4·gpt-oss·qwen3.8 27b 정도.
2. 스왑 없이 재려고 네 번 측정. 큰 모델을 먼저 돌리면 뒤 결과까지 오염되고, 켜 둔 앱도 변수.
3. 살아남은 건 gpt-oss 20b(로그 과제 89%, 문제당 36초)와 gemma4 12b(61~63%). gemma4 26b는 푸는 중에도 스왑, qwen3.8 27b는 스왑 38~171GB.
4. Claude Haiku·Sonnet은 92~100%, 문제당 7~8초. gpt-oss 20b는 숫자로는 Haiku 바로 아래지만 12문제라 같은 수준이라고는 못 함.
5. 평소엔 Claude, 로컬은 보험. 보험 모델을 gpt-oss 20b로 바꿈.
· · ·
도움이 됐다면 공유 부탁드립니다!
#로컬LLM #Ollama #맥미니 #gptoss #gemma4 #ClaudeCode
'토큰탕진 실험실' 카테고리의 다른 글
| 로컬 LLM은 보험이다|맥미니 24GB에선 느려서 평소엔 안 쓰고, Claude 한도 떨어진 날 꺼내 쓴다 (0) | 2026.10.29 |
|---|---|
| 싼 모델 Haiku 5.5로 서브에이전트 바꿔도 될까?|30번 돌려 보니 싼 게 꼭 싸지는 않았다 (0) | 2026.10.23 |
| Aside·ego-lite, Claude Code에 이틀 붙여 본 종합|WebFetch·Chrome까지 상황별로 뭘 쓰나 (0) | 2026.10.22 |
| 요즘 핫한 Aside, Claude Code에 붙여 하루 써 봤다|Chrome보다 느린데 계속 쓰는 이유 (0) | 2026.10.21 |
| 내 Claude Code 환경 vs 기본 상태, 같은 과제로 붙여 봤다|서브에이전트 7개 중 일한 건 1개 (0) | 2026.10.16 |


